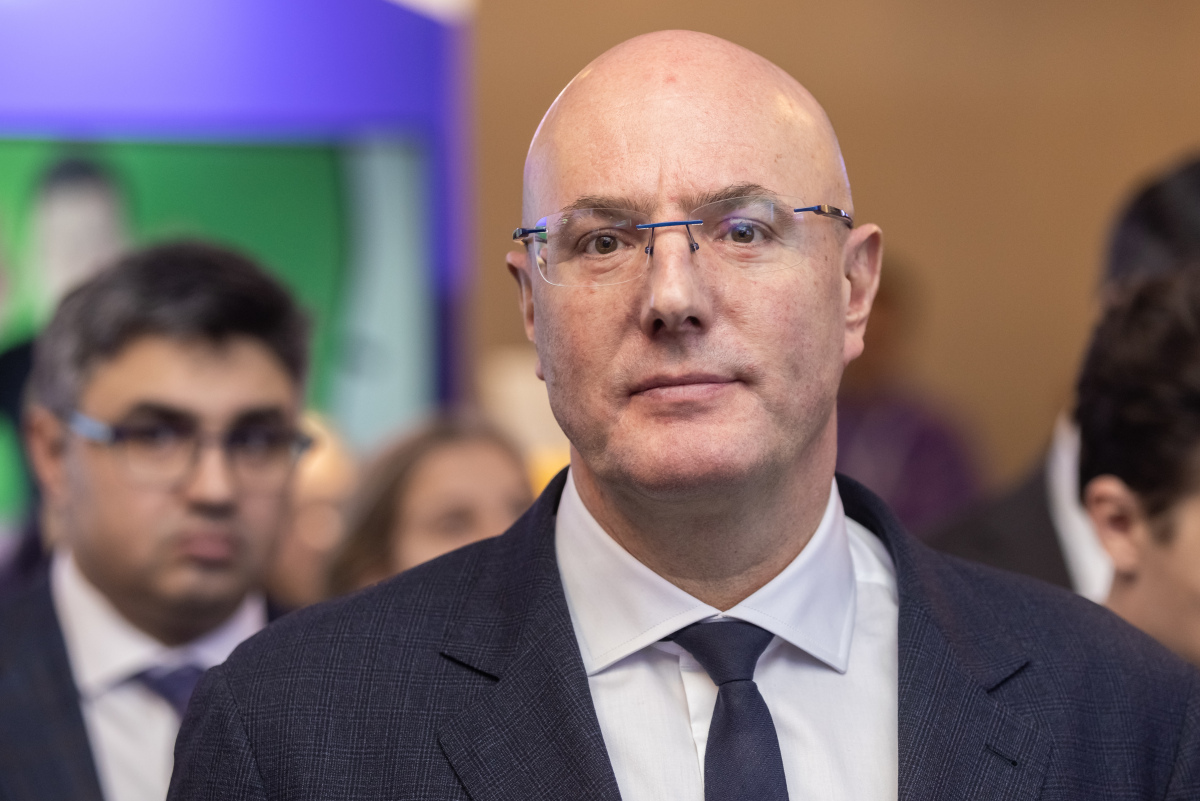
Россия оцифрует советское научное наследие, чтобы обучать на нем отечественные ИИ-модели. Об этом сегодня на пленарной сессии «Цифровых дней Иннополиса» заявил вице-премьер РФ Дмитрий Чернышенко.

Дмитрий Чернышенко
Фото: «БИЗНЕС Online»
«Мы переводим в цифру, вы слышали, фонды государственной системы научно-технической информации. У нас задача оцифровать все наше советское наследие <…> Все это наследие создаст суперпозицию для наших обученных суверенных моделей», — сказал он.
Данные Чернышенко назвал первым из трех условий развития ИИ в науке наряду с вычислительными мощностями и доступом ученых к ним.
В государственной базе сейчас около 1,5 млн статей и других научных материалов. Кроме того, ожидается поступление около 600 млн научных данных на микрофильмах, карточках и других материалах. Это наследие вице-премьер предложил беречь в том числе от дистилляции и от неправомерного использования. Под дистилляцией понимают обучение одной модели на ответах другой.
Чернышенко активно продвигает инициативу по созданию отечественных дата-сетов с учетом российской и советской специфики. Ранее он объяснял, что подобные массивы данных необходимы для обучения нейросетей с целью корректного распознавания сложных исторических контекстов и архивных материалов.
Источник: БИЗНЕС Online